一、硬件拓扑与 NUMA 架构深度解析
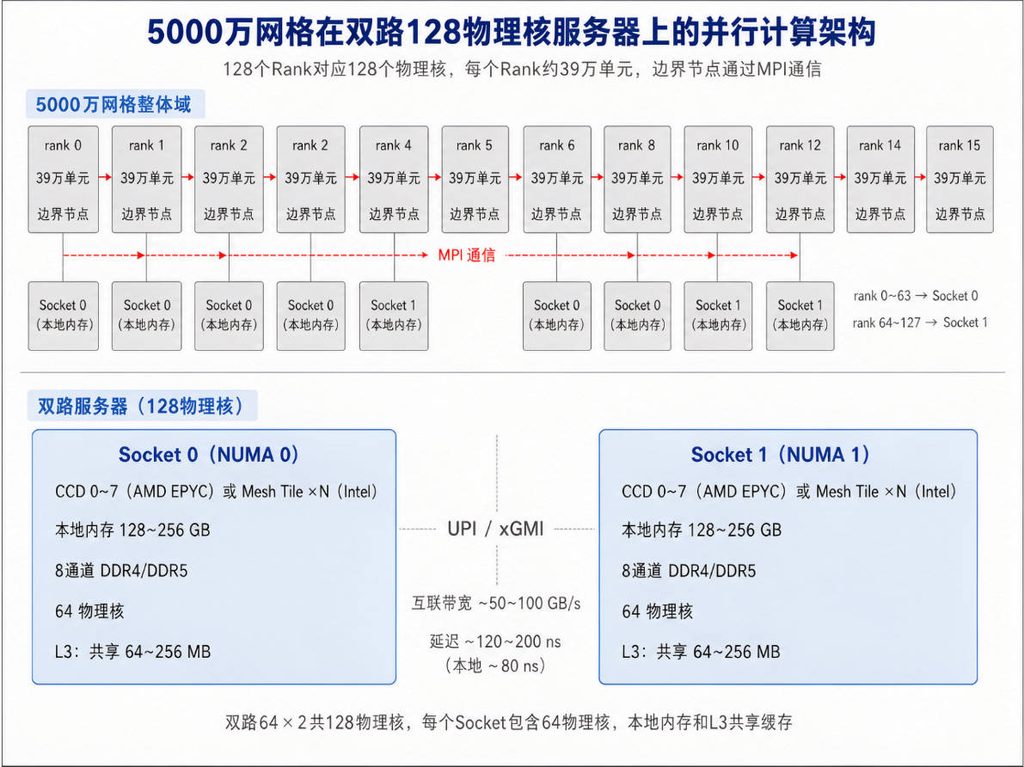
1.1 双路 64×2 的物理布局
1.2 跨路访存的性能代价
| 访存类型 | 延迟 | 带宽 | 对 Dyna 的影响 |
|---|---|---|---|
| 本地 NUMA 访存 | ~80 ns | ~200 GB/s/路 | 理想状态,每步 rank 内部数据全走本地 |
| 跨路远程访存 | ~120~200 ns | ~50~100 GB/s(互联瓶颈) | 单步慢 1.5~2.5×,且 MPI 同步时放大 |
| NUMA 未绑核随机漂移 | 混合(~30%跨路) | 带宽碎片化 | 整体 wall time 增加 20%~40% |
关键洞察:Dyna MPP 每个 rank 的单元状态变量(stress, strain, plastic strain, history vars)在每步被全量读写。若 rank 0 跑在 Socket 0 但内存分配在 Socket 1,每步 39 万单元的应力更新全部走跨路——这不是偶尔一次,是每步几十万次访存 × 每步 × 几十万步,累计代价极其恐怖。
1.3 超线程在浮点密集型负载下的微观机制
物理核 0(关闭超线程):
  └── rank 0 → 独占执行单元(ALU/FPU/AVX)→ 100% 利用率

物理核 0(开启超线程,提交 256 rank):
  ├── rank 0 → 执行单元 50% 时间片
  └── rank 128 → 执行单元 50% 时间片
      ↑ 两个 rank 的 FPU 指令排队等执行单元
      ↑ L1/L2 cache 互相驱逐
      ↑ 每步 MPI 同步时,两个 rank 互相等待
Dyna 每步的计算特征是:
- 纯浮点密集:力计算、应力更新、本构积分全是 FMA(乘加)指令
- 连续内存访问:单元循环遍历,cache line 友好
- 极少分支/等待:不像 IO 型任务会 stall 等磁盘/网络
超线程的设计初衷是掩盖延迟(cache miss、分支预测失败),让另一个线程在 stall 时空跑。但 Dyna 几乎没有 stall——两个线程同时抢 FPU,反而互相拖慢,实测加速比 < 1.0(即 256 逻辑核比 128 物理核更慢)。
二、Rank 域分解与负载均衡的微观机制
2.1 域分解原理
LS-DYNA MPP 启动时(或预分解 pfile 中):
- 读取完整网格
- 按 METIS/SCOTCH 算法将网格切成 N 个子域(N = rank 数)
- 每个 rank 只持有自己的子域数据
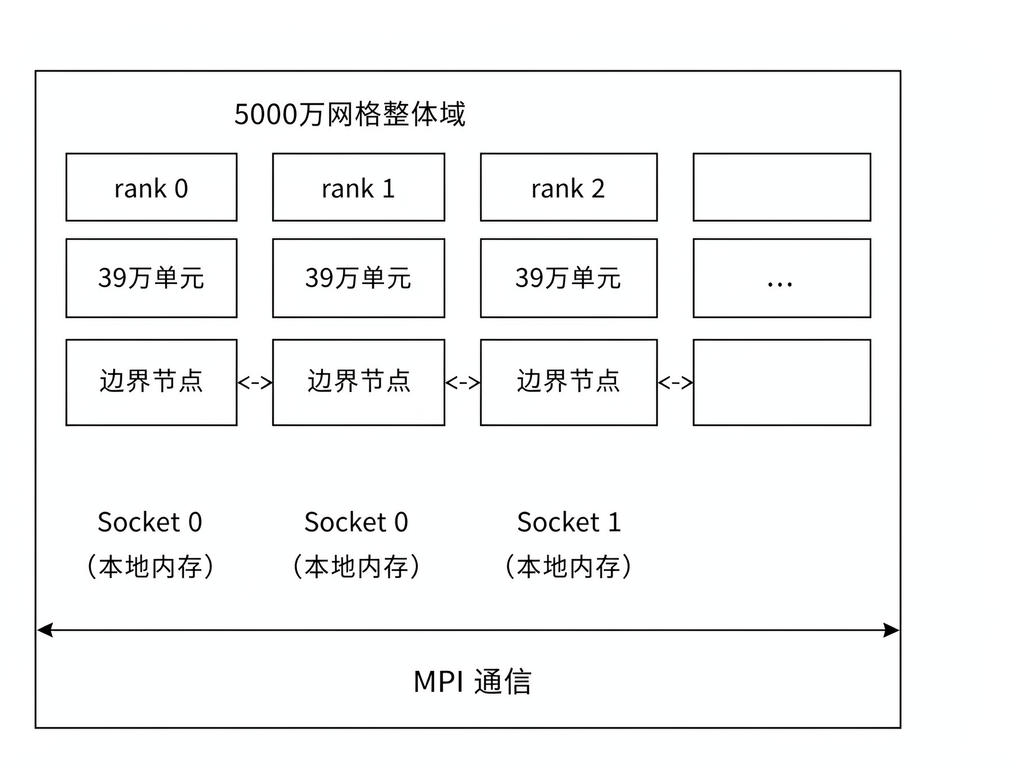
- 子域边界上的节点需要与邻居 rank 交换
2.2 通信/计算比的量化估算
以 5000 万六面体网格、128 rank 为例:
| 参数 | 估算值 |
|---|---|
| 总单元数 | 50,000,000 |
| 每 rank 单元数 | 390,625 |
| 假设每单元 8 节点,共享后每 rank 独立节点 | ~45,000 |
| 边界节点占比(表面积/体积) | ~3%~5% |
| 每步每 rank 通信数据量 | ~45,000 × 5% × 24字节(DOF×double)≈ 54 KB |
| 每步每 rank 计算量 | 390,625 × ~200 FLOP/单元/步 ≈ 78 MFLOP |
| 通信时间(IB/万兆) | ~54 KB / 5 GB/s ≈ 0.01 ms |
| 计算时间 | ~78 MFLOP / 2 GFLOPS ≈ 0.04 ms |
| 通信/计算比 | ~20%~25% |
⚠️ 这是理想估算。实际接触对、ALE/SPH、复杂材料会增加单步计算量,通信比进一步降低。这就是为什么 39万/rank 在当代硬件上效率好——通信被计算完全淹没。
2.3 负载不均衡的风险与检测
域分解算法尽量让每个子域单元数相等,但接触搜索和材料计算的开销不跟单元数严格成正比:
| 不均衡来源 | 影响 |
|---|---|
| 接触对集中在某几个子域 | 那几个 rank 每步多做接触搜索,拖慢全局 |
| SPH 粒子分布不均 | 粒子密集区 rank 计算量暴增 |
| 自适应重分(ALE) | 某些步某 rank 突然多算很多 |
| 小特征密集区 | 小单元导致局部 CFL 步长变小,该 rank 等别的 rank |
检测方法:
# 提交时加
memory2=500m  # 增大工作区以输出更多诊断

# 运行后查看
grep "time per zone cycle" d3hsp
# 或查看 load_profile.xy(需编译时开启)
理想状态:最大 rank 耗时 / 最小 rank 耗时 < 1.2。超过 1.5 说明严重不均衡,需调整分解策略(如 decomp 关键字手动指定权重)。
三、内存子系统深度分析
3.1 每 Rank 内存占用拆解
以显式 5000 万网格、128 rank、双精度为例:
| 数据类别 | 每单元/节点估算 | 每 rank 总量 |
|---|---|---|
| 节点坐标 + 位移 + 速度 + 加速度 | 4 DOF × 8B × ~45K 节点 | ~14 MB |
| 单元连接 + 材料映射 | ~200 B/单元 × 390K | ~78 MB |
| 应力/应变张量(6分量 × 8B × 积分点) | ~48 B/单元 × 390K × 2 IP | ~37 MB |
| 历史变量(塑性应变、损伤等) | ~40 B/单元 × 390K | ~15 MB |
| 接触数据(段、穿透检查) | 取决于接触对密度 | ~10~50 MB |
| 边界通信缓冲区 | ~2 MB | ~2 MB |
| 合计(单 rank 工作集) | ~160~200 MB |
128 rank × 200 MB = ~25~26 GB 纯数据。
加上 Dyna 内部临时数组、MPI 缓冲区、OS 开销:
- 实际总内存需求:200~300 GB(与你之前的估算吻合)
- 若双精度 + 复杂材料 + 大量接触 → 可能冲到 350 GB
3.2 memory 参数的精确含义
memory=2000m    # 每 rank 主堆区(用于网格数据、状态变量)
memory2=200m # 每 rank 辅助区(用于接触、临时数组、MPI buf)| 参数 | 分配时机 | 不够的表现 |
|---|---|---|
memory | 启动时一次性分配 | d3hsp 报 “out of memory” 直接崩溃 |
memory2 | 运行中动态使用 | 运行时报 “memory2 exhausted”,或悄悄写 swap 导致极慢 |
调参策略:
- 先设
memory=1500m memory2=200m试跑 - 若 d3hsp 显示
maximum memory used接近上限 → 逐步加 500m - 若总内存 512 GB,128 rank → 每 rank 理论可用 ~4 GB,设
memory=3000m留余量给 OS
3.3 NUMA 内存分配策略
# 方法1:启动时指定 NUMA 策略
numactl --cpunodebind=0 --membind=0 rank_0_to_63 &
numactl --cpunodebind=1 --membind=1 rank_64_to_127 &

# 方法2:MPI 自动绑(推荐)
export I_MPI_PIN_DOMAIN=numa
# Intel MPI 会自动让 rank 的内存分配在对应 socket 的 NUMA 节点上
验证:
numactl --show  # 看当前进程的 NUMA 策略
numactl --hardware  # 看各 NUMA 节点内存总量和剩余
四、显式求解器的数值细节
4.1 中心差分的时间积分
显式每步做的事情(伪代码):
for each timestep t:
    // 1. 节点力计算(并行,各 rank 独立)
    F_int = ∑(B^T σ dV)          // 单元内力
    F_ext = 外力(压力、重力等)
    F_contact = 接触力搜索 + 计算  // 可能跨 rank

    // 2. 加速度更新
    a(t) = M^{-1} (F_ext - F_int + F_contact)
    // M 是集中质量矩阵(对角阵),求逆 = 除法,O(N)

    // 3. 速度更新
    v(t+Δt/2) = v(t-Δt/2) + a(t) × Δt

    // 4. 位移更新
    u(t+Δt) = u(t) + v(t+Δt/2) × Δt

    // 5. 边界通信(MPI)
    exchange_boundary_data()

    // 6. 状态更新(并行,各 rank 独立)
    for each element:
        更新应变 ε = B · u
        调用本构模型 → 更新应力 σ
        更新历史变量(塑性应变等)

    // 7. 时间步长重算(CFL 条件)
Δt = min(Δt_element) × safety_factor关键特征:
- 第 2 步
M^{-1}是对角阵求逆 → 每个节点独立算,无全局耦合 - 第 5 步是唯一需要 MPI 同步的地方
- 第 6 步完全本地,不跟任何 rank 通信
这就是为什么通信量只跟边界节点有关,跟总单元数无关。
4.2 CFL 条件与步长控制
Δt ≤ CFL × L_min / c_sound| 参数 | 含义 |
|---|---|
L_min | 最小单元特征长度 |
c_sound | 材料中声速 = √(E/ρ) |
CFL | 通常 0.9(默认) |
实际影响:
- 若网格有极小特征(倒角、薄壁、尖角)→
L_min极小 → Δt 极小 → 步数暴增 - 5000 万网格若最小单元 1mm、钢(c=5000 m/s)→ Δt ≈ 0.9 × 0.001 / 5000 ≈ 1.8e-7 s
- 若模拟 10ms 碰撞 → 需要 ~55,000 步(合理)
- 若模拟 100ms → 550,000 步(单精度累积误差开始显现,考虑双精度)
4.3 能量守恒作为精度校验
显式求解的能量平衡方程:
E_total = E_kinetic + E_internal + E_hourglass + E_contact + E_sliding + E_external每步输出 glstat 中的各能量分量。校验标准:
E_total漂移 < 5% → 单精度可接受E_hourglass / E_internal> 10% → 需要加密网格或换单元类型E_kinetic在碰撞后不归零 → 检查约束/边界条件
五、单精度 vs 双精度的数值机制
5.1 舍入误差的累积路径
单精度(32bit):
  有效数字 ~7 位十进制
  最小正规数 ~1.18e-38
  机器精度 ε ≈ 1.19e-7

双精度(64bit):
  有效数字 ~15~16 位
  最小正规数 ~2.23e-308
  机器精度 ε ≈ 2.22e-16
显式积分的截断误差来源:
- 时间积分截断:中心差分的局部截断误差 O(Δt²) → 与精度无关
- 舍入误差:每次浮点运算的 round-off → 单精度每步 ~1e-7 相对误差
- 累积路径:√N 增长(随机游走)或 N 增长(最坏情况)
N 步后累积误差 ≈ ε × √N   (随机游走,典型)
              ≈ ε × N     (最坏情况)

单精度,N=100,000 步:
  累积 ≈ 1.19e-7 × √100000 ≈ 3.8e-5  (~0.004%)
  最坏 ≈ 1.19e-7 × 100000 = 1.19e-2  (~1.2%)

双精度,N=100,000 步:
累积 ≈ 2.22e-16 × √100000 ≈ 7e-14 (可忽略)结论:步数 < 10万,单精度累积误差 < 0.1%,工程可接受;步数 > 50万,单精度最坏情况可达 6%,需要双精度兜底。
5.2 位移增量/总位移比的问题
后期振动分析中,每步位移增量可能只有 ~1e-6 m,而总位移 ~1e-2 m:
增量/总量 = 1e-6 / 1e-2 = 1e-4单精度有效数字 7 位,在 1e-2 量级的位移上只能分辨到 ~1e-9 的变化——看起来够用? 但累积计算中会先加后减(中心差分涉及 v(t+Δt/2) 的更新),有效数字在中间步骤被吃掉。双精度在 1e-2 量级上有 15 位有效数字,能分辨 ~1e-17 的变化,完全不受限。
六、提交脚本的完整参数注释版
#!/bin/bash
# ============================================================
# LS-DYNA MPP Explicit - 5000万网格 - 双路128物理核 最优配置
# ============================================================

# --- CPU 绑定 ---
export OMP_NUM_THREADS=1          # 纯 MPP,禁用 OpenMP 线程
export I_MPI_PIN_DOMAIN=numa      # 每 NUMA 域一组 rank(双路=2组)
export I_MPI_PIN_CELL=unit        # 绑到 core 级别(非 thread)
export I_MPI_DEBUG=4              # 启动时打印绑核信息(验证用)

# --- 内存控制 ---
# memory: 主堆区,存网格+状态变量(每 rank)
# memory2: 辅助区,存接触+临时数组+MPI buf(每 rank)
# 5000万/128核 ≈ 39万/核,单 rank 工作集 ~160~200MB
# 设 2000m 留 10 倍余量(含 Dyna 内部碎片 + 接触数据)
MEMORY_MAIN="2000m"
MEMORY_AUX="200m"

# --- 输出控制 ---
JOBID="crash_50M_128core_$(date +%Y%m%d_%H%M%S)"
INPUT="model.k"
PFILE="decomp.pfile"             # 预分解文件(提前用单进程生成)

# --- 启动 ---
mpirun -np 128 \
  -genv I_MPI_PIN_DOMAIN=numa \
  -genv I_MPI_PIN_CELL=unit \
  -genv I_MPI_DEBUG=4 \
  ls-dyna_mpp_s \
    i=${INPUT} \
    p=${PFILE} \
    memory=${MEMORY_MAIN} \
    memory2=${MEMORY_AUX} \
    jobid=${JOBID} \
    2>&1 | tee ${JOBID}.log

# --- 后处理检查 ---
echo "=== 提交完成,运行后请检查 ==="
echo "1. d3hsp 中 'time per zone cycle' → 各 rank 是否均衡"
echo "2. glstat 中能量曲线 → 总能量漂移是否 < 5%"
echo "3. load_profile.xy → 最大/最小 rank 耗时比 < 1.2"
七、故障排查速查表
| 现象 | 根因 | 对策 |
|---|---|---|
| wall time 比预期慢 2×+ | NUMA 未绑核,跨路访存 | 确认 I_MPI_PIN_DOMAIN=numa 生效 |
| 提交 256 核反而更慢 | 超线程争抢 | BIOS 关 HT,或只提交 128 |
| d3hsp 报 out of memory | memory 不够 | 逐步 +500m 重试 |
| 运行时极慢但没崩 | memory2 不够,写 swap | 加大 memory2,或检查接触定义 |
| 某 rank 明显拖后腿 | 负载不均衡(接触集中) | 查看 load_profile,调整 pfile 权重 |
| 能量不守恒(>10%) | 单精度累积误差 | 换 _d 双精度重跑 |
| MPI 报错 timeout | 某 rank 崩溃或死锁 | 检查 d3hsp 最后几行 + 系统日志 |
| 输出 d3plot 过大 | 双精度 + 高频输出 | IBINARY=1 强制 32 位输出 |